
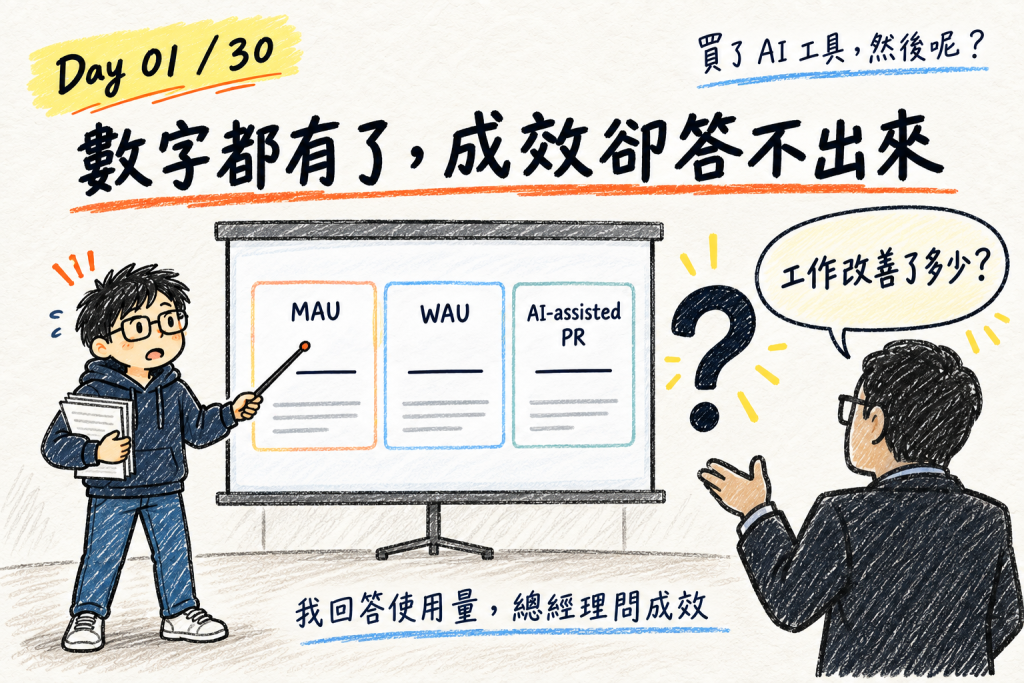
有一次主管會議,總經理問到買了 AI 工具之後的成效。他的問題很具體:開發有沒有變快?維運的人力負擔有沒有降低?
我不是空手去的。工具買了一段時間,團隊也真的在用,我把使用紀錄整理過:每個月有多少人活躍、一週有多少人用、多少 PR 帶著 Claude 參與的痕跡。每個數字都是真的,也都算得出來。
報完之後,會議室安靜了一下。我發現自己回答的是「大家用了多少」,他問的是「工作變好了多少」。
這兩句話中間差了十萬八千里。這三十天,我想把那段差距補起來。
為了搞清楚自己到底缺什麼,我把「AI 有沒有效」拆成五層。這是本系列的工作定義,用來對齊問題與證據,不是什麼學術模型。
| 層次 | 要回答的問題 | 要看什麼 |
|---|---|---|
| L1 使用 Adoption | 大家有在用嗎? | 活躍與任務紀錄,還有它們怎麼算 |
| L2 工程 Engineering | 交付能接受嗎? | 程式、測試、驗收與退件 |
| L3 人員 People | 人的工作改善了嗎? | 操作、審查、返工、接手的實際投入 |
| L4 成本 Economics | 這筆投入值得嗎? | 工具費用加上人工與維護的完整帳 |
| L5 業務 Business | 原本要改善的工作變好了嗎? | 開發交付是否加速、維運負擔是否下降,品質有沒有守住 |
那天我最能回答的是 L1,總經理問的是 L5。
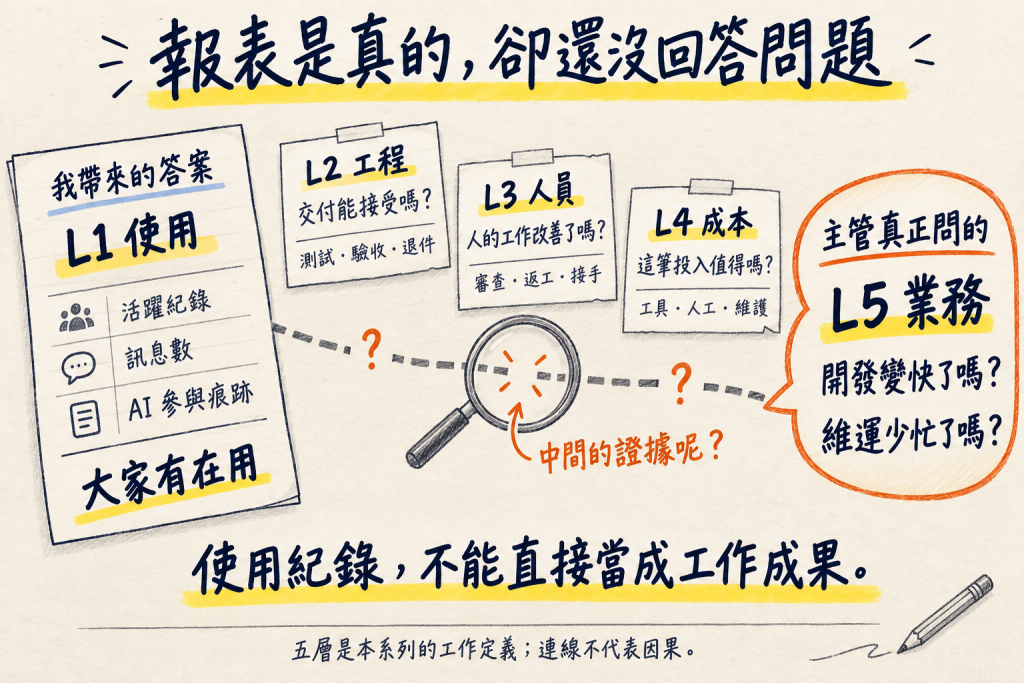
圖中的斷線是待補的證據;五層不會因為排在一起,就自動串成因果。
這張表對我的用處是知道下一步該找什麼資料。AI 讓某個環節少做了幾步,先看人的投入有沒有改變(L3);要說開發變快,就得看整段交付,不能漏掉後面的等待、審查與返工(L5)。上一層有答案,不代表下一層自動成立。
五層幫我釐清要問什麼;DORA、SPACE 與 DX Core 4,則提供挑選證據的角度。它們不是三套都要做滿的報表,也不是和五層一對一對應。
| 資料或框架 | 主要看什麼 | 在這五層裡怎麼用 |
|---|---|---|
| 使用紀錄 | 活躍、訊息、Token、Claude 署名 | 支援 L1;還不能回答交付品質與工作成果。 |
| DORA | 變更前置時間、部署頻率、失敗部署恢復時間、變更失敗率、部署重工率 | 支援 L2 的交付表現;對照原本的改善目標,才成為 L5 的部分證據。 |
| SPACE | 滿意與福祉、績效、活動、溝通協作、效率與流動 | 跨層檢視,尤其補 L3 的工作經驗與協作;提醒我不能只用活動量代表生產力。 |
| DX Core 4 | Speed、Effectiveness、Quality、Impact:速度、效能、品質與影響 | 協助平衡 L2、L3、L5 的問題;速度變快時,也要看工作阻力、品質與投入方向。 |
| 成本與人工紀錄 | 工具費、操作、審查、返工與維護 | 補 L4 的完整帳;不能拿生成速度直接換算省下的人力。 |
例如 DORA 的變更前置時間看的是從 commit 到正式部署,不包含所有需求等待;SPACE 讓人的感受與協作進入視野,但滿意度仍不等於實際省時。DX Core 4 的 Impact 可用新能力投入比例觀察工作方向,也不等於客戶價值或財務回報已經實現。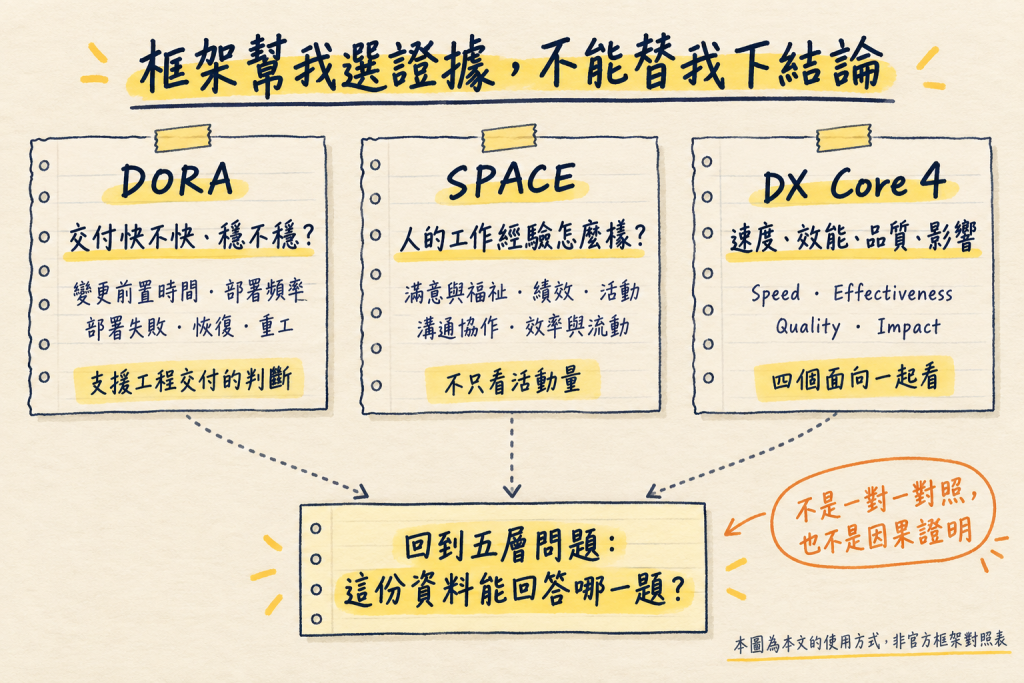
我會先問「這份資料能回答哪一題」,再決定放哪個指標。上面的對照是本文的使用方式,並非官方框架對照表,也不能靠指標變好就判定是 AI 造成的。
框架原始說明:DORA 交付指標、SPACE 研究、DX Core 4 指南。
以我當時整理的使用資料為例:claude.ai 網頁對話和 Claude Code 的 Git 紀錄分在兩處,我把它們接成一個活躍定義:
當日活躍 = 當日有 claude.ai 訊息,或有 Claude 署名的 commit
問一句問題和修改一個模組,都會被記成「當日活躍」。這個值能整理可見的使用痕跡,卻分不出投入深度,更不能直接回答交付是否變快。
Git 這一邊,我找的是 commit 訊息裡的署名:
Co-Authored-By: Claude <noreply@anthropic.com>
只要 PR 裡有一筆帶署名的 commit,我就記為有 Claude 參與痕跡。但署名可能關閉或被移除;有署名,也分不出 Claude 改的是核心邏輯還是一行 import。它是可修改的文字線索,不是完整的使用紀錄,也不是品質證明。
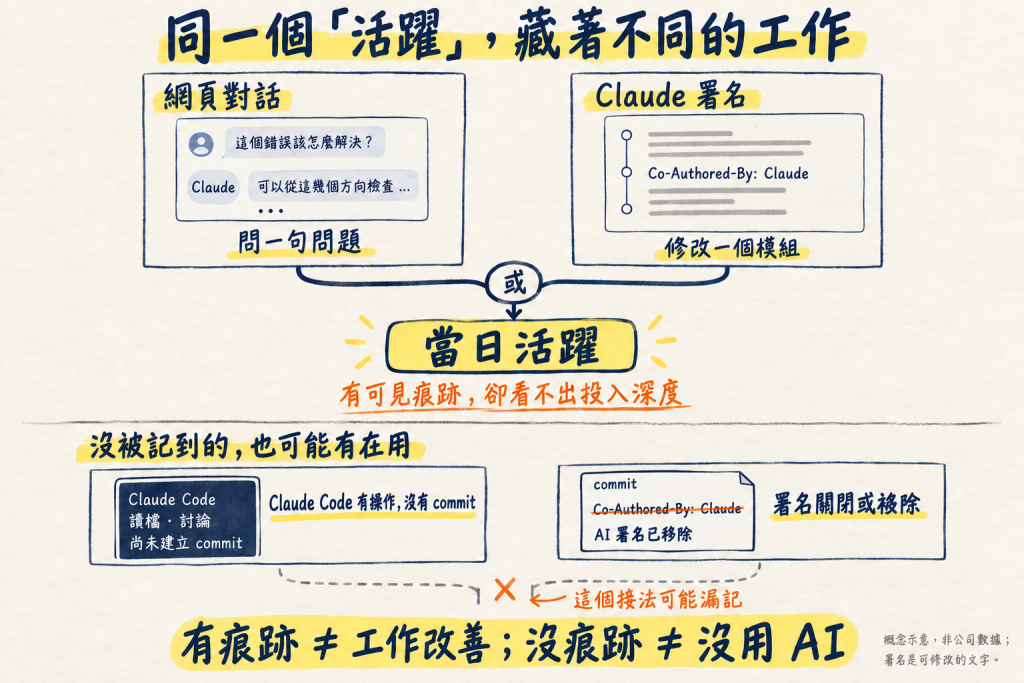
圖中都是示意:上半部是不同工作被記成同一個值,下半部是可能漏掉的使用。
Git 只是其中一個入口。也可以透過 OpenTelemetry(OTel)收集 Claude Code 的執行資料,建立自己的 Dashboard;這能補另一部分觀測,但活動時間仍不等於完整人工投入,更不等於省下的時間。官方觀測說明
資料收得更完整,仍要回到五層問題:使用量回答 L1,工作有沒有改善,要另外找證據。
回頭整理這些經驗,像是把散落的嘗試蒸餾成可以反覆追問的問題;這只是我的比喻,不是替系列套上一個官方框架。
如果後續確認成果沒有改善,「作業方式沒有改變」可以是待查解釋之一;目前還不能預設成果沒動,更不能先認定原因。
| 總經理期待 | 我手上有 | 還不知道 |
|---|---|---|
| 開發更快 | 使用紀錄、Claude 署名等參與痕跡 | 同類工作從受理到可用是否縮短 |
| 維運負擔降低 | 部分工具與工單紀錄 | 工作量、難度與品質相近時,總人工投入是否下降 |
| 投資產生效果 | 帳號、席次與活躍資料 | 改善有多少來自 AI,有多少來自人員或流程變化 |
先把總經理的問題放最上面,再往下找證據,而不是先打開報表找能用的欄位。那天我做的事,用《九品芝麻官》的話講就是「拿明朝的劍斬清朝的官」:使用報表是回答 L1 的工具,我卻拿它去斬 L5 的問題,劍再利也不對案。
要回答開發有沒有加速,先選一類可比較的需求,看從受理到可用的時間,再用開發、審查、部署各段資料找變化發生在哪裡,同時確認品質沒有變差。
要回答維運負擔有沒有降低,先固定服務範圍,記錄總人工投入,再對照工單量、難度與處理品質。工作量增加時,就算單件變快,總負擔也可能上升,那就如實寫。
使用量還是要留。它告訴我在觀察期間 AI 是否真的進入了那段工作。但前後結果變好,也還要看同期有沒有流程、人員或工作內容的改變,不能全部歸給 AI。
先量一次自己手上最容易拿到的那份痕跡。在任何一個你用 Claude Code 工作過的 repo 執行:
git log --since="30 days ago" --grep="Co-Authored-By: Claude" --format="%ad %an" --date=short | sort | uniq -c
輸出大概長這樣(示意,不是公司資料):
   3 2026-08-14 marcus
   1 2026-08-15 marcus
   6 2026-08-19 marcus
跑完先核對:有署名的日子,和你實際使用的紀錄差在哪裡?有使用卻沒留下 commit,或移除了署名,都可能漏記。查到的也是 commit 次數,不能直接當成交付件數。這個小練習只查 L1 的一部分。
那場會議留下的問題,我還想繼續追下去。工具已經有人在用,但它究竟改變了哪些工作,又有哪些事情沒有跟著改變,值得回到現場慢慢看。
這三十天,我想把過去一年自己摸索 Claude Code 與 AI 協作的過程整理成文章:從學到的知識、慢慢形成的理解,到實際拿來應用的經驗。有些嘗試確實幫上忙,有些要多走幾步,才看清原先忽略的地方。這些收穫,連同還沒想通的問題,都會一起留下來。
希望下次再被問到「買了 AI 工具,然後呢?」時,我能說得更具體一點。
參考資料:


 iThome鐵人賽
 看影片追技術